不只是“更小、更强”:AI如何重写一把运动的基因剪刀
2026年7月16日,诺贝尔化学奖得主 Jennifer Doudna 团队在顶级学术期刊 Science 上发表论文《Structure and evolution-guided design of minimal RNA-guided nucleases》,以天然的微型核酸酶 TnpB 为原型,将结构指导的 AI 设计与天然序列中的进化信息结合,创造出一组自然界中不存在的核酸酶 SynTnpBs,具备体内基因编辑的潜力。
原文链接:https://www.science.org/doi/10.1126/science.aed6123
用人工智能改造基因编辑器已经不是新鲜事。近年来,研究人员利用 AI 大模型和蛋白设计,已经改造获得了多种新型基因编辑工具酶。那么,Doudna 团队这项工作为什么仍然值得关注?
1 为什么基因编辑器需要"减肥"?
提到基因编辑,很多人首先想到的是 CRISPR/Cas9 系统。它像一把由 RNA 导航的分子剪刀:向导 RNA 寻找目标序列,Cas 蛋白负责切开 DNA。然而,一个现实问题始终困扰着研究者——这把剪刀有些太大了。
常规的 SpCas9 蛋白含有 1368 个氨基酸,对应 DNA 编码序列长度已经达到 4.1 kb。如果再融合一些其他元件变成碱基编辑器,编码序列将轻松超过 5 kb。但是,常用于递送这套工具的腺相关病毒载体(AAV)的有效装载容量只有 4.7 kb。很多情况下,研究人员不得不把基因编辑系统拆分到两个载体中,增加了递送难度。
将基于 Cas9 的基因编辑系统拆分装载之后,AAV 的剂量也同步增加,随之带来的肝肾毒性等副作用绝不可小觑。国内某高校仇姓研究员对 6 岁儿童进行基因编辑治疗,导致患儿不幸去世,其直接原因很可能就是大剂量 AAV 载体引起的严重副作用。
而 TnpB 是由一类由转座子编码的核酸酶,最大的特点就在于"小"。本研究采用的 ISDra2 TnpB 只有约 400 个氨基酸组成,大小仅为 SpCas9 的 1/3 不到。尽管体积紧凑,TnpB 仍能与引导 RNA(reRNA)组成复合物,识别并切割特定位置的 DNA。但是,天然 TnpB 的活性、靶点范围和细胞适应性还不够理想。
能否在保留 TnpB 的小尺寸同时,重新设计其蛋白质序列,从而提高其基因编辑性能?
2 过去很多 AI 设计,仍然站在天然蛋白附近
已有不少工作利用 AI 模型生成新的核酸酶。不过,大多数模型生成的蛋白虽然整体序列有所变化,但其中负责识别 DNA 的关键结构域,与天然蛋白仍保持超过 99% 的序列一致性。这类工作就更像是在天然工具周围寻找新版本:结果可能有用,但关键部件仍大量采用自然界已经验证过的答案。
而 Doudna 这篇论文选择了一条更激进的路线。研究人员使用 ESM-IF1 逆向折叠模型,先提供 TnpB 的三维骨架,再让模型寻找能够折叠成这一结构的全新氨基酸序列。初步生成的新序列与天然 ISDra2 TnpB 只有约 50%~60% 的一致性,已经明显偏离了天然序列,不再是在天然蛋白上更换少量几个零件。
但"长得像",并不等于"会工作"。TnpB 工作时,是一台在多个构象之间来回转换的分子机器。某条 AI 序列即使能折叠成正确形状,也可能无法识别核酸,或者卡在切割前的某一步。
初始设计就暴露了这个问题:设计出的序列保留了整体折叠构象和催化三联体,却也改动了部分核酸序列识别和结合的关键残基。
3 让 AI 负责探索,让进化标出"承重墙"
研究团队因此给 AI 加入两类进化约束(图1)。
第一类约束:位置保守性
在大量天然 TnpB 中长期不变的氨基酸,往往承担关键的催化或结构功能。
第二类约束:蛋白质与 RNA、DNA 的共进化关系
如果核酸中的某个碱基发生变化,蛋白质中的某个氨基酸残基也经常随之改变,那么两者可能存在重要接触。
研究人员固定这些关键位点,把其余区域交给 ESM-IF1 重新设计。结构模型像一名富有想象力的设计师,进化信息则像总工程师,告诉它哪些部件可以改,哪些承重结构不能拆。
这一方法的意义不限于 TnpB。对于缺少完整动态结构、却拥有大量天然同源序列的蛋白质,进化信息也可能帮助识别实验结构没有捕捉到的瞬时功能位点。
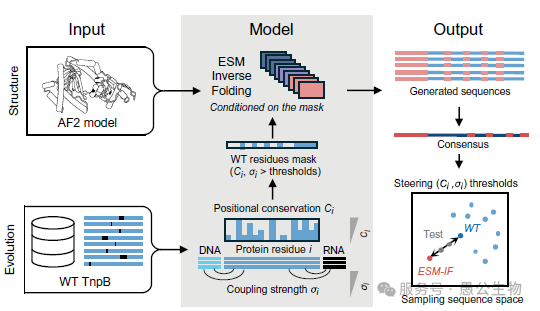
图 1 总体设计策略(来自原文 Figure 1)
4 从 1,980 种设计中筛出真正能工作的核酸酶
研究人员进一步将 TnpB 分成两个模块:主要参与 DNA 识别的 REC,以及主要负责 reRNA 结合和 DNA 切割的 NUC。
实验发现,两部分对改造的耐受度截然不同。只使用单一进化约束时,16 个 NUC 设计中有 13 个保留活性,REC 叶却只有 1 个能工作。这提示多结构域蛋白不能用同一种强度"一刀切"地设计。
团队随后同时采用保守性和共进化信息,将 44 种 REC 与 45 种 NUC 两两组合,共测试 1,980 种组合。
最终,从 1980 种构建中筛选到约 24% 有活性,约 8% 的活性超过天然 TnpB。团队进一步选出 9 个兼顾活性与序列差异的候选,命名为 SynTnpB-v1 至 v9,继续在人和植物细胞中验证(图2)。
关键提醒
这个结果也说明,AI 并没有实现"生成即成功"。它提高的是探索遥远序列空间的效率,真正的功能仍要通过大规模实验筛选。
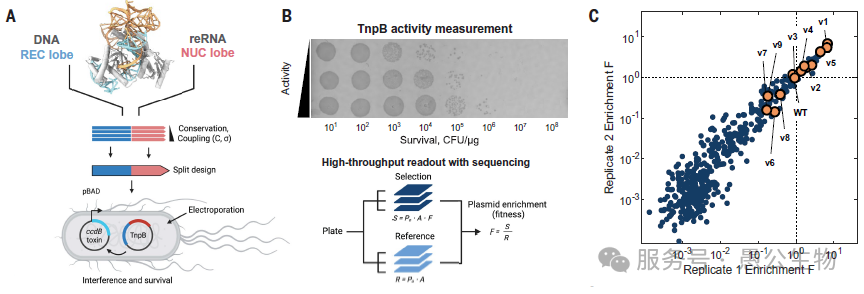
图 2 AI 设计 TnpB 突变体:通过 REC/NUC 结构拆分组合、高通量筛选及测序分析,鉴定高活性 TnpB 突变体。(来自原文 Figure 2)
5 活性更高,不代表一定更精准
在人胚肾 HEK293T 细胞的蓝色荧光蛋白 BFP 敲除实验中,天然 TnpB 的平均编辑率为 28%,设计出的 SynTnpB-v1 和 v5 分别达到 46% 和 50%。
在人内源 EMX1 基因上,天然 TnpB 的编辑率为 7%,v1 和 v5 分别达到 26% 和 21%,约为天然版本的 3.8 倍 和 3.1 倍。同时,人工蛋白还在拟南芥原生质体中表现出优于天然蛋白的编辑活性,说明其功能能够跨越细菌、植物和哺乳动物细胞环境。
v1 在另一个人内源基因 RUNX1 上的编辑效率就低于天然 TnpB,v5 在部分靶点也没有优势。另一方面,全基因组分析也显示,v1 的整体特异性与天然 TnpB 相近,但 v5 和 v7 则检测到更多脱靶位点。"切得更多"不等于"切得更准",基因编辑核酸酶的活性和特异性必须分别测量、分别优化。
6 冷冻电镜捕捉到一帧"工作中间态"
SynTnpB-v7 与天然 TnpB 的序列一致性只有 77%,它为何还能工作?
研究人员使用冷冻电镜,获得了两个高分辨率的 SynTnpB-v7 与 reRNA、靶 DNA 形成的复合物三维结构。其中尤为引人注意的是,获得了此前 TnpB 研究从未解析到的构象中间体(图3)。在这个状态下,蛋白已经抓住靶 DNA,但向导 RNA 与 DNA 只形成种子区的第一个碱基对,就像高速摄影捕捉到分子剪刀启动的一瞬间。
结构显示,AI 设计的氨基酸在 reRNA、DNA 种子区和 RNA-DNA 杂交链周围形成了新的静电作用与氢键网络。当研究人员把部分人工氨基酸改回天然版本后,核酸酶活性随之下降,进一步说明这些新设计的氨基酸确实参与了分子机器的工作。
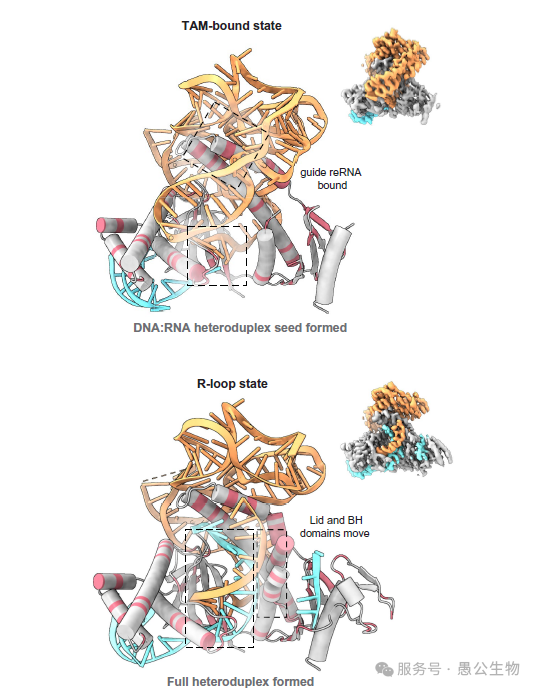
图 3 AI 设计的 SynTnpB-v7 突变体与核酸复合体冷冻电镜结构(来自原文 Figure 4)。
上图为 TAM 结合构象中间体,下图为 RNA-DNA 杂交链已经充分形成的 R-loop 形成态。
7 为什么它值得发表在 Science?
这项研究的价值可以归纳为三点。
-
第一,它设计的不是一个静态蛋白,而是一台需要识别RNA、DNA并连续变换构象的复杂分子机器。
-
第二,它没有停留在天然序列附近,而是在大幅改写关键功能区域后,仍保留了可编程编辑能力。并通过细胞实验、冷冻电镜和反向突变说明,它为什么还能工作。
-
第三,它提出了一个可推广的框架:结构负责定义总体蓝图,进化负责保护功能约束,AI负责探索新序列,实验和结构生物学负责最终裁决。
当然,SynTnpB 还远不是基因治疗工具成品。研究尚未进行动物体内治疗验证;活性提升存在靶点依赖性;部分变体出现更多脱靶;大幅变化的蛋白质序列也需要免疫原性评价。
但这并不削弱其方法学意义。它证明,即使是依赖复杂构象运动的核酸酶,也有可能在离开天然序列邻域后被重新设计。
从"寻找"到"设计"
过去,基因编辑工具主要靠"从自然界中寻找";未来,研究人员或许可以根据递送方式、靶序列和细胞环境,主动设计一把适合具体任务的分子剪刀。
这才是这篇论文比"又一种 AI 设计的核酸酶"更值得关注的地方。