无细胞蛋白合成新范式:跳过纯化,快速解析蛋白变体互作
AI 蛋白设计、定点突变文库会源源不断产出大量蛋白变体。传统流程需要逐个分子克隆—细胞表达—多步纯化,周期漫长,大量变体卡在功能验证环节。
东京大学 Tsumoto 团队连续发表 FASTIA(2025)、MAXTIA(2026)两套平台,将 PUREfrex 重构型无细胞蛋白合成,分别对接 BLI 与高通量 SPR,直接拿粗反应样品做完整动力学测定,2—3 天完成几十至数百变体的功能解析,为抗体亲和力成熟、功能表位作图提供全新实验路径。
行业痛点:变体序列爆炸,功能验证成为最大瓶颈
做抗体工程、丙氨酸扫描突变,经常遇到这样的现实矛盾:
很多课题组只能退而求其次:
两套平台:从数十变体到 384 孔高通量表位作图
(一)FASTIA:普通 BLI 即可上手,抗体变体快速解析(Protein Science, 2025)
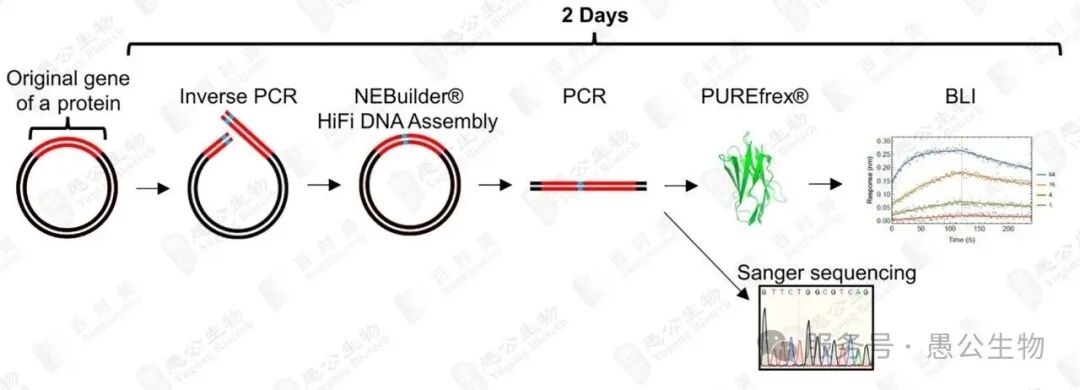
工作流程:
-
以原始母本质粒为模板,PCR 引入点突变并组装,得到各个突变体的线性 DNA 片段;
-
直接将线性 DNA 投入 PUREfrex 无细胞反应,小体积孵育数小时完成蛋白翻译;蛋白 C 端带上 10×His 标签;
-
无细胞粗产物稀释,直接上 Octet HIS1K 传感器,粗样品中 His 标签蛋白被传感器捕获;
-
采用非再生单循环动力学:同一个传感器依次浸入梯度升高的抗原,中间不做传感器再生,拟合输出完整 kon、koff、KD;
-
整套流程仅需 2 天即可完成 20 多个变体分析。
文章验证案例
选用抗溶菌酶 VHH D2-L29,对全部 CDR 残基做丙氨酸扫描;拿到各个突变体动力学参数,映射到晶体结构,快速定位参与相互作用的关键氨基酸残基。数据趋势和传统纯化蛋白的测定结果保持一致。
关键发现
CDR3 在 D2-L29 与 HEL 的相互作用中起核心作用,Y29、Y100、C106、R109 突变后结合几乎完全丧失,是相互作用热点;框架区(FR)也参与抗原结合,F37、F50、Y60、W111 突变亲和力显著下降;而位于界面边缘的 R45、G47 突变后亲和力反而升高,提示这些区域存在进一步优化的空间。
(二)MAXTIA:升级 384 孔高通量 SPR,抗原侧大规模功能表位作图(Protein Science, 2026)
MAXTIA 升级为 Carterra 高通量 SPR,目标面向抗原侧大规模丙氨酸扫描、做残基水平功能表位解析,通量提升到 384 个变体同时测定。
完整工作流程:
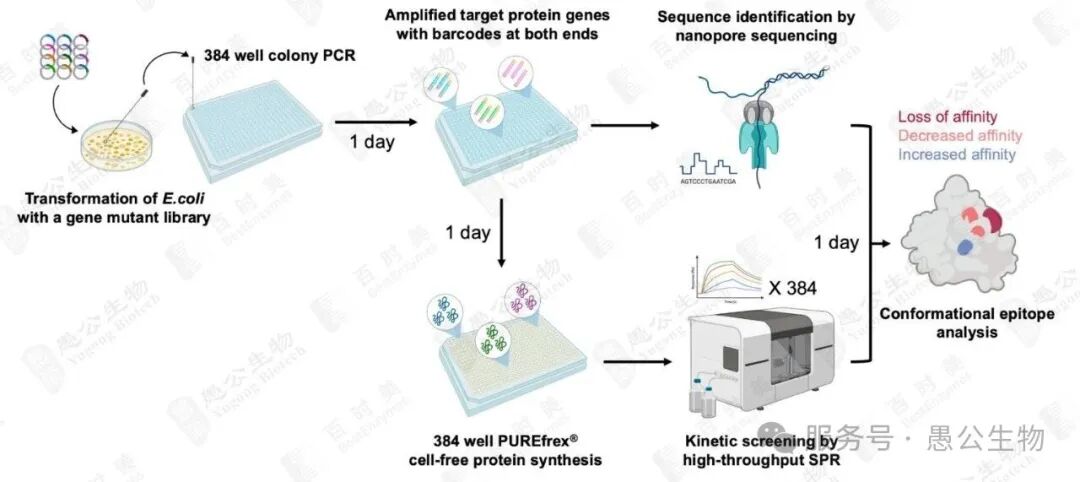
MAXTIA流程示意图
-
构建抗原丙氨酸突变文库,转化大肠杆菌,挑克隆排布 384 孔板;
-
384 孔菌落 PCR(colony PCR)扩增各突变体 DNA,两端带条形码;取部分 PCR 产物混合做纳米孔测序,完成序列核验,区分单克隆与杂克隆;
-
PCR 产物直接作为模板投入 PUREfrex 无细胞体系,384 孔并行合成抗原变体;
-
粗样品直接上 Ni-NTA 高通量 SPR 芯片捕获;以不同浓度抗体作为分析物进样,单循环动力学拟合,输出每个突变体完整动力学并计算 ΔΔG(结合自由能变化);
-
3 天之内完成最多 384 个变体的完整动力学测定,把能量贡献映射到蛋白三维结构,定位功能热点残基。
文章验证案例
以神经元正五聚蛋白NP2 PTX与 VHH N1 为模型体系。依据 AlphaFold3 预测结构,对 77 个溶剂暴露残基做丙氨酸扫描;在两次独立实验循环中,成功解析了其中 74 个变体的完整动力学(1 个变体未在菌落 PCR 中回收,2 个因拟合质量差被排除)。
关键发现
V412、G415、S417、K418、W419、P420 六个残基在 NP2 PTX 表面形成一个连续的功能表位簇;其中 W419 突变后检测不到任何结合,是至关重要的能量热点。
动力学拆分显示,V412A、S417A、K418A、P420A 亲和力下降主要由 koff 升高驱动,而 G415A 则主要由 kon 降低驱动,说明不同残基承担不同的机制角色。
同时识别出若干"冷点"残基:Y235、K241、G414、R257 突变后亲和力反而升高,说明这些界面接触残基的结合能贡献并不理想、甚至存在空间位阻,去掉它们的侧链反而更有利。这类信息无法仅从静态晶体结构推断,正是定量突变方法的价值所在。
透过两篇论文,理解无细胞蛋白合成真正的核心价值
很多人简单理解无细胞只是"蛋白表达更快",结合 FASTIA、MAXTIA,我们可以看到它更大的工程意义:
干掉分子克隆瓶颈PCR 产物、商业合成线性 DNA 直接作为翻译模板。AI 批量设计、定点突变文库,不需要逐个构建质粒、转化挑克隆,大幅降低变体制备工作量。
打通"设计—合成—测试—迭代"闭环AI 蛋白设计最大痛点:算法可以输出几百条序列,但湿实验验证跟不上,分不清是算法缺陷还是蛋白表达折叠失败。无细胞+BLI/SPR 快速拿到kon、koff、KD 定量数据,把真实实验反馈给计算模型,完成快速迭代。
赋能丙氨酸扫描,解析分子识别机理传统丙氨酸扫描工作量巨大,每个突变体都要走完表达纯化。FASTIA、MAXTIA 让大规模丙氨酸扫描变得可及;不仅判断"结合/不结合",还可以拆分突变分别对 kon(结合速率)、koff(解离速率)的贡献,用来指导亲和力成熟、理性抗体改造。
承接 NGS 文库筛选输出的大量候选变体NGS 测序会输出海量抗体序列,但测序丰度不等于亲和力。这套工作流可以快速对大量候选变体做动力学分级筛选。
写在最后
变体 DNA 文库 → 逐个克隆—细胞表达—纯化 → 仅少数变体测动力学,大量序列被丢弃。
变体 DNA 文库 → 无细胞并行翻译 → 粗样品直接高通量 BLI/SPR 得到动力学参数 → 初筛压缩候选集合 → 少数重点变体再纯化,做金标准表征与功能实验。
无细胞蛋白合成,不只是更快产出蛋白,而是正在改变抗体与蛋白工程早期研发的工作流,打通从大量变体序列到定量功能数据之间最耗时的环节。
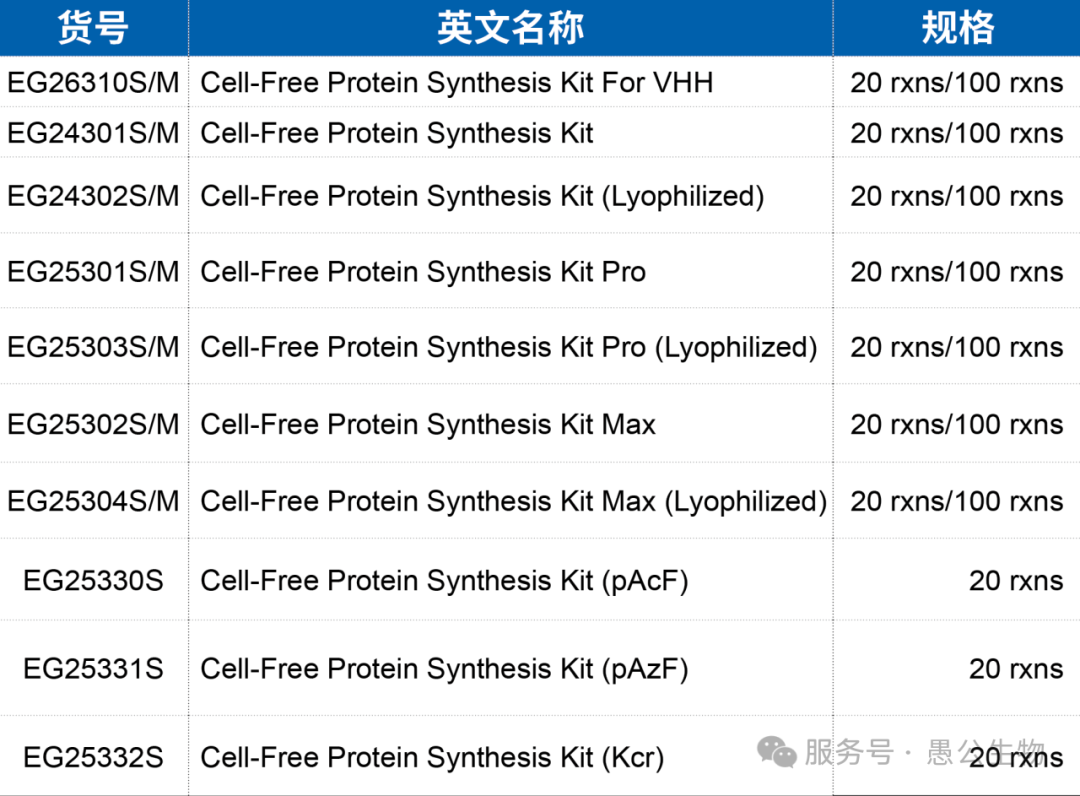
相关产品