Nature 重磅|改写生命的翻译字典!
2026年8月26日,哈佛大学医学院、Wyss研究所Felix Radford 与 George Church 团队在 Nature 发表题为 Automated prototyping of genetic codes 的研究论文,带来了一套名为 AGENTEX 的自动化工作流,在无细胞体系中搭建出一套与天然翻译系统并行运行的"第二遗传密码表",并利用它实现了密码子重新分配和非天然氨基酸插入,为大规模密码子重编程打开了全新大门。
改造天然遗传密码的梦想
生命世界看似千变万化,但从细菌到人类,几乎所有生物都在使用同一套编码规则。DNA上的遗传信息会被先转录成信使RNA(mRNA);mRNA的编码区域中,每三个碱基构成一个密码子;与每个密码子(终止密码子除外)对应的就有一种转运RNA(tRNA),其末端携带一个对应的氨基酸。翻译时,核糖体每次读取mRNA上一个密码子,结合一个对应的tRNA,把tRNA携带的氨基酸顺次组装成蛋白质。
天然的4种碱基可以组成64种密码子,但天然氨基酸只有20种,大量密码子是冗余重复的(图1)。
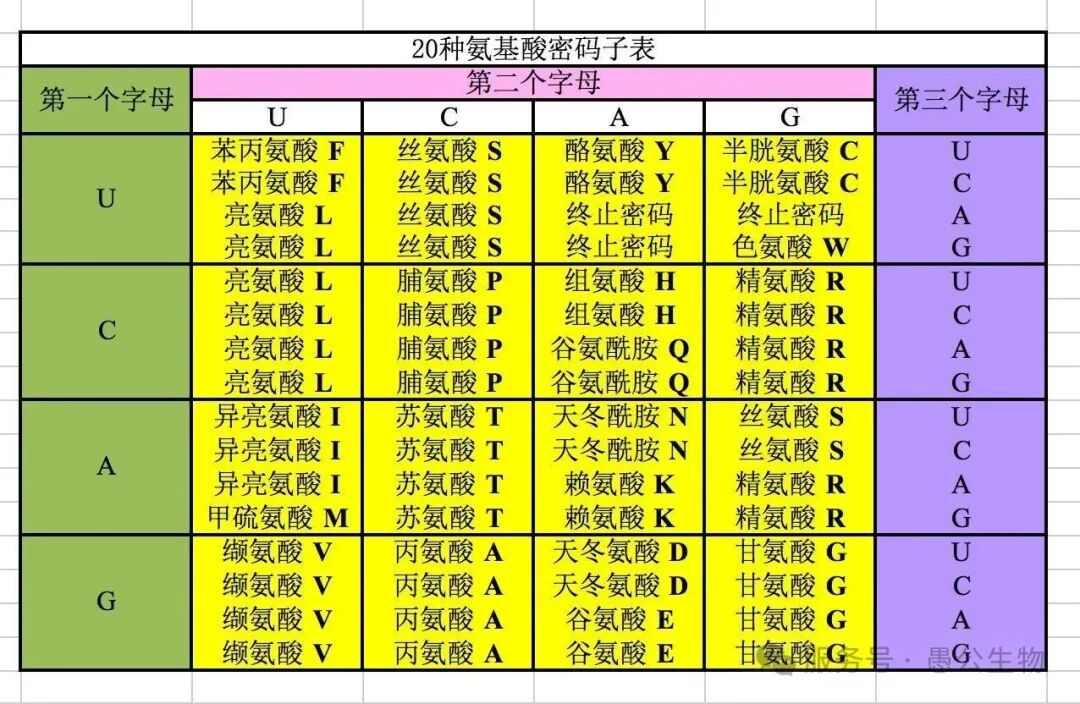
合成生物学家一直有一个宏大梦想:解放这些多余密码子,编入非天然氨基酸,制造自然界从未出现的蛋白或多肽新材料。
但现实却极其骨感。
过去重编程密码子,需要大刀阔斧改写活细胞的整个基因组,稍有不慎就扰乱细胞正常生存;而且活细胞内的翻译机器会互相关联干扰,很难同时重分配多个密码子,每新增一种非天然氨基酸都要付出巨大代价。
如果使用无细胞蛋白合成系统,虽然绕开了活细胞的限制,能够更便捷引入非天然氨基酸,但也存在不少短板:
常用的细胞裂解液系统能够保留RNA修饰、更接近体内环境、适合放大生产。但含有宿主全套内源tRNA,能够解放的密码子有限(一般只有3个终止密码子),可能会和人工tRNA发生交叉干扰,阻碍人工密码子测试。
组分完全纯化,适合概念验证,但不具备RNA修饰活性,不适合规模化生物合成。
因此,如何通过无细胞蛋白合成系统,大规模改写密码子呢?
颠覆旧认知:tRNA的3'末端远比想象中更加灵活!
教科书告诉我们:所有天然tRNA的3’末端都有一段绝对保守的CCA序列(图2)。过去普遍认为,CCA是氨酰‑tRNA合成酶(aaRS)给tRNA挂上氨基酸必不可少的元件,一旦突变,tRNA就无法装载氨基酸,彻底失效。
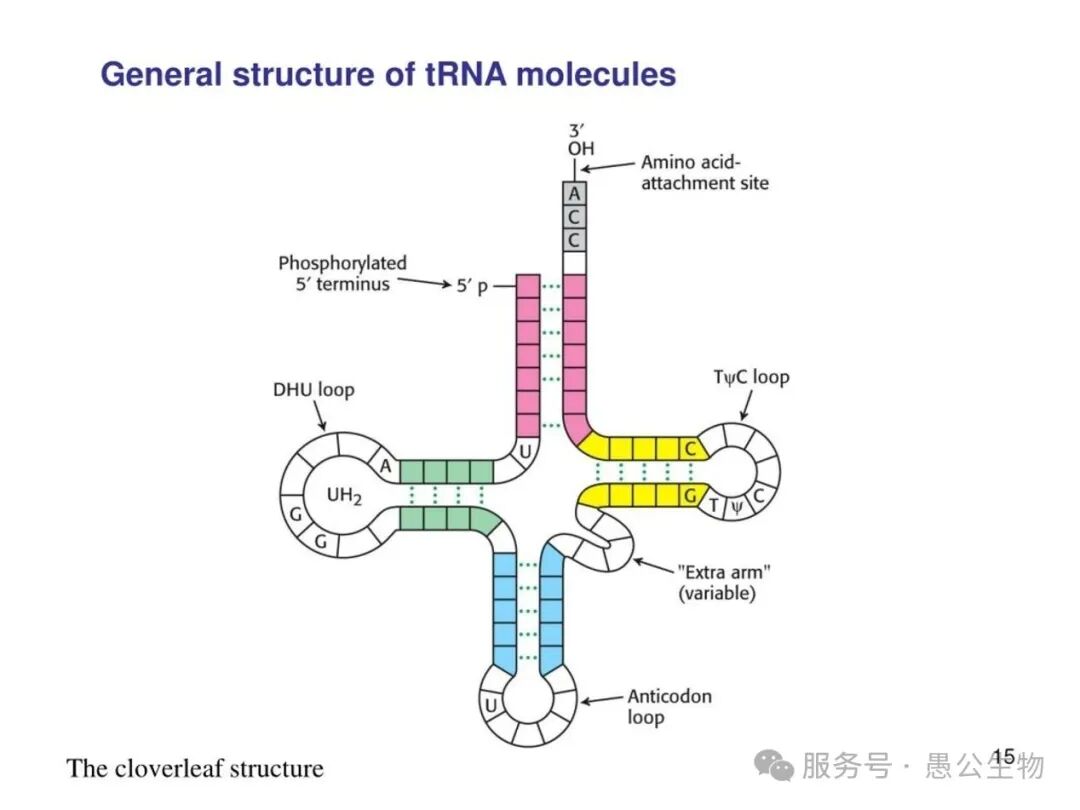
但是,本文作者测试了大量末端突变的tRNA文库,惊奇地发现,绝大多数非CCA末端的tRNA(otRNA),依然可以被氨酰‑tRNA合成酶挂上正确的氨基酸。其中CGA末端的tRNA整体表现最优。换句话说,氨酰‑tRNA合成酶识别tRNA时并不只看CCA末端,还会综合读取tRNA主体、受体臂、反密码子环等多个特征。
使用现有的无细胞体系发现,tRNA修饰能够显著提升otRNA的氨酰化效率。如果使用PURE无细胞体系,因为缺少tRNA修饰,导致otRNA装载效率显著低于裂解液无细胞体系。
那为什么自然界所有生物都死死守住CCA?
前人研究已经知道,核糖体大亚基23SrRNA依靠两个关键碱基G2251、G2553识别tRNA的CCA末端,只有携带CCA的tRNA才能进入核糖体完成翻译。如果把核糖体这两个碱基G突变为C,改造后的核糖体就可以接纳3'端是CGA的otRNA。
在此基础上,作者进一步揭示了一套双重遗传密码维持机制:
即便tRNA末端不是CCA,依然可以完成氨基酸装载。
即便otRNA已经带上氨基酸,野生核糖体依然坚决拒绝它参与蛋白质翻译,彻底隔绝另类翻译通路。
也就是说:真正守住标准遗传密码的,不是负责装载氨基酸的合成酶,而是负责蛋白合成的核糖体!只要核糖体不接纳,就算tRNA已经带上氨基酸,也无法制造另类蛋白质。只有当核糖体同步突变,otRNA才可以上岗工作。
于是,一套巧妙的平行翻译体系形成了:
天然CCA-tRNA由天然核糖体读取,执行标准遗传密码;工程otRNA则主要由突变核糖体读取,执行重新设计的密码表。两套系统可以共享天然氨酰tRNA合成酶,却在核糖体这个层面被分隔开。可以把它理解为:两套操作系统使用同一个充电站,但拥有不同的接口标准,彼此的设备不能随意接入对方。
AGENTEX完整工作流:设计-构建‑测试‑学习闭环
基于以上发现,作者利用开源的自动化平台,构建了全程不依赖活细胞的tRNA拓展平台AGENTEX(图3)。
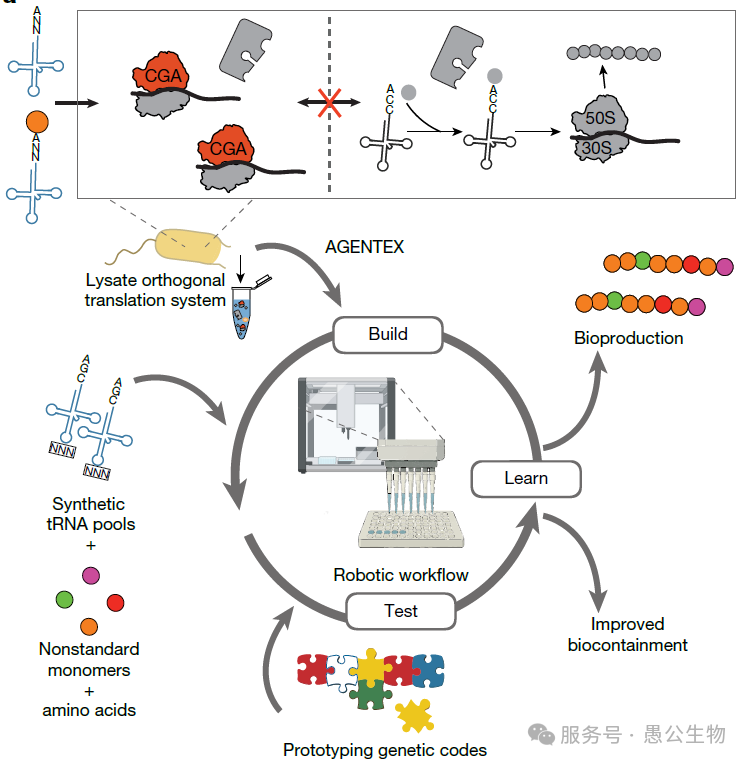
核心基础是特制的大肠杆菌裂解液,向其中的核糖体23SrRNA上引入了G2251C、G2553C两个突变。这些突变的核糖体只识别3'-CGA结尾的otRNA,拒绝天然CCA‑tRNA。裂解液自身仍然保留全套天然氨酰‑tRNA合成酶与RNA修饰酶,可给otRNA挂上氨基酸。
这套系统的工作流程是:
-
根据目标人工密码,设计整套otRNA(3'‑CGA末端,自定义反密码子,实现密码子重分配),重新分配密码子。
-
合成otRNA对应的DNA模板,自动完成PCR扩增、体外转录、磁珠纯化,批量得到otRNA文库;
-
同时自动合成对应的mRNA报告模板,用来验证翻译效果。
-
将otRNA文库、mRNA模板加入携带CGA核糖体的裂解液无细胞体系;
-
裂解液内部氨酰‑tRNA合成酶给otRNA完成氨基酸装载;
-
CGA突变核糖体特异性读取otRNA,按照这套人工遗传密码翻译多肽;
-
整套孵育、翻译、蛋白纯化全部自动化完成,一次可以并行测试多套不同的遗传密码方案。
翻译产物产出之后,系统自动进行多维度评估:
-
HiBiT发光报告:快速判断翻译是否成功、翻译效率高低;
-
高分辨率质谱:精准解析多肽序列,检查保真度,排查错义翻译、系统串扰;
-
自主开发的tSCAN测序技术:检测otRNA的氨酰化(氨基酸装载)效率。
实验数据直接反馈给设计端,自动调整tRNA序列、反密码子搭配,生成下一轮待测试的遗传密码方案,循环迭代优化。
AGENTEX系统自带生物安全隔离,全部组件放到外界活细胞中无法发挥功能。即便发生泄露,也不能制造改造生命体,可以安全测试那些非常激进、自然界不存在的翻译系统。
什么是"压缩遗传密码"?
生物体标准的64个密码子存在大量同义冗余。本研究对于20种标准氨基酸,每种只选择1个主要密码子,用1种otRNA解码,搭配起始和终止密码子,仅仅占用22个密码子。
随后,为每种氨基酸选择一条合适的otRNA,修改其反密码子,使它读取指定密码子,考虑到摆动配对的影响,部分密码子仍会被保留tRNA顺带识别。经过计算,作者最终得到14个可重新分配的编码通道(图4)。理论上,这些空出的编码位置可以被分配给非天然氨基酸、化学修饰单体,甚至自然蛋白质中从未出现过的聚合物构件。
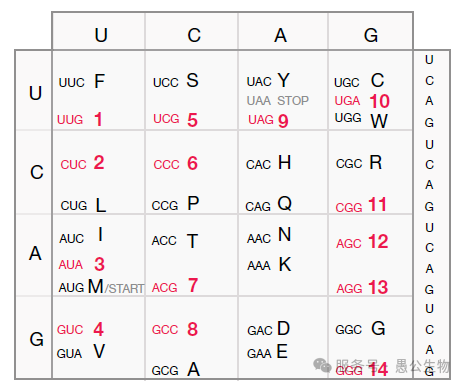
黑色表示沿用的天然密码子,红色表示释放的密码子
为了证明新密码子表真的在运行,作者进行了一项非常直观的实验:交换丝氨酸和丙氨酸的密码子。
在天然密码子表中,UCC编码丝氨酸,GCG编码丙氨酸。在工程密码表中,研究人员让携带丙氨酸的otRNA读取UCC,让携带丝氨酸的otRNA读取GCG。这相当于把键盘上"A"和"S"两个按键的输出结果交换。
研究团队设计了含有多个相关位点的报告肽,并用液相色谱-串联质谱分析翻译产物。结果显示,天然核糖体产生标准序列,工程核糖体则产生符合交换密码子表的序列。在检测限内,没有发现两套密码表混合读取形成的杂合肽。更重要的是,工程系统成功翻译出一条32个氨基酸的多肽,说明otRNA并非只能偶尔插入一次,而是可以连续参与多轮翻译。
完成密码子压缩后,下一步就是把空出来的密码子交给非天然氨基酸。
作者选择了天然密码子中负责终止的UAG,将它重新分配给对叠氮苯丙氨酸(pAzF)。为了让UAG编码pAzF,额外引入了一条源自古菌的工程tRNA。这条tRNA带有CUA反密码子,可以识别UAG;它的3'末端同样被改成CGA,因此主要进入工程核糖体。与此同时,体系中同时加入对叠氮苯丙氨酰‑tRNA合成酶(pazFRS)。它负责识别这条tRNA,并把pAzF装载到tRNA上。
利用HiBiT荧光报告系统发现,在同时加入CGA核糖体、工程otRNA池、pAzF和pazFRS时,荧光信号约为天然核糖体裂解液的6倍,比无模板对照高约10倍。去掉功能性pazFRS后,信号下降到接近背景水平。
这说明,该系统中20种标准氨基酸的密码子重分配不需要改造额外的氨酰-tRNA合成酶,这正是该论文重大创新。但拓展非天然氨基酸,依然要沿用经典的外源正交氨酰‑tRNA合成酶和tRNA组合。
这项工作带来了什么?
改写遗传密码维持的传统模型。遗传密码不是仅仅由tRNA/氨酰-tRNA合成酶相互作用决定,还包括了核糖体、tRNA修饰等多层协同维持。这为研究生命起源、RNA世界提供新视角。
这篇论文真正改变的,不只是几个密码子的归属,而是遗传密码工程的研发方式。过去遗传密码重编程需要改造活细胞全基因组,风险高、周期长。现在先在试管内用机器人快速试错各种人工遗传密码,评估完效率、保真度之后,再去改造生命体,极大降低基因组重编码的试错风险。从这个意义上说,AGENTEX更像是一座"遗传密码风洞":它不能直接造出一架真正的新飞机,却可以在起飞之前,快速检验哪一种设计最有可能成功。
-
合成含有多位点非天然氨基酸的多肽药物、序列精准的生物高分子材料;
-
探索完全不属于自然界的翻译规则;
-
未来有望迁移到活细胞,在体内搭建平行正交遗传密码。
当然也要看到局限:AGENTEX目前是无细胞体外系统。真正构建拥有全新密码的活生命体,还需要解决染色体、代谢网络等更高阶的细胞生理挑战。
写在最后
生命共用一套遗传密码,是生物学最宏大的统一规律之一。
而现在人类开始不再只是读懂这本生命字典,而是可以在试管里批量编写、测试一本本全新的翻译字典。
正如论文讨论部分所言,AGENTEX给我们打开一扇窗口: